Das Wichtigste in Kürze
- Content-Lifecycle-Management umfasst jede Phase, die Content durchläuft, von der Planung und Erstellung über die Veröffentlichung und Pflege bis zur Archivierung. So bleibt Content korrekt, auffindbar und markenkonform.
- Im Enterprise-Umfeld ist die Content-Pflege eine Abhängigkeits-Kette: Ändert sich ein Quell-Dokument, müssen alle damit verknüpften übersetzten oder wiederverwendeten Versionen geprüft werden. Andernfalls driften die einzelnen Märkte auseinander.
- Immer mehr Käuferinnen und Käufer nutzen KI, um Marken zu finden. Deshalb wird es wichtiger, KI-Systeme mit korrektem Content zu versorgen. Veraltete Seiten, die weiterhin online sind, können als aktuell zitiert werden.
- Eine Plattform, die Content als strukturierte, miteinander verknüpfte Objekte abbildet, wie die CoreMedia Digital Experience Platform, macht auch die späteren Phasen beherrschbar. Gleichzeitig entsteht Content, den KI-Systeme lesen können und dem sie vertrauen.
- Weitere Informationen zu Rollen für Nutzerinnen und Nutzer sowie zu Content-Regeln bietet unser Leitfaden zur Content-Governance.
Was ist Content-Lifecycle-Management?
Content-Lifecycle-Management bezeichnet die Steuerung jedes einzelnen Content-Elements durch alle Phasen seines Bestehens, von der Planung und Erstellung über die Veröffentlichung und Pflege bis hin zur Archivierung. So bleibt Content korrekt, konsistent und leicht auffindbar, solange er online ist.
Es ist die operative Disziplin rund um Content: Für jedes Asset ist klar geregelt, wer was wann übernimmt, ganz gleich, ob es sich um eine Landing-Page, eine Produkt-Beschreibung, einen Hilfe-Artikel oder ein Video handelt.
Bei einem einzelnen Team, das nur wenige Seiten pro Jahr veröffentlicht, läuft dieser Prozess informell ab. Irgendjemand behält im Blick, was online ist und was bei einem neuen Produkt-Launch aktualisiert werden muss. Im Enterprise-Umfeld mit Hunderten von Redakteurinnen und Redakteuren, Dutzenden Märkten und Tausenden Seiten kann jedoch niemand allein den Überblick behalten. Der manuelle Ansatz stößt hier an seine Grenzen.
Genau dann braucht Content-Lifecycle-Management einen verbindlichen Prozess statt einer Gewohnheit: klar benannte Verantwortlichkeiten für jede Phase, definierte Auslöser für die Überprüfung von Content und einen Prozess, der auch bei Personal-Wechseln Bestand hat.
Die Phasen des Content-Lebenszyklus-Managements
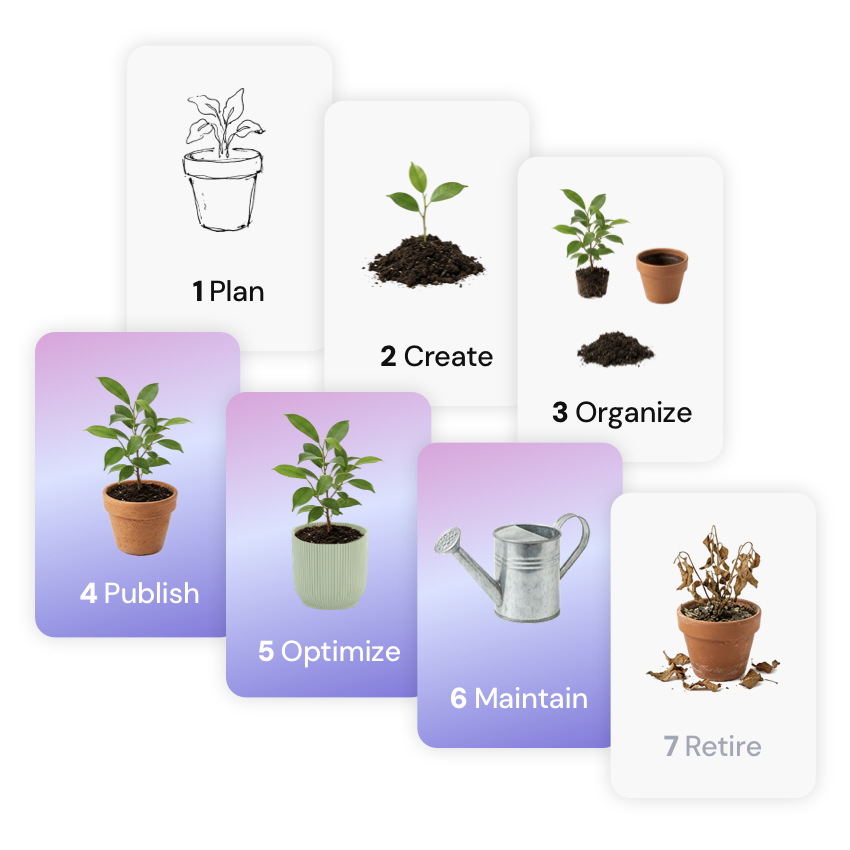
Die meisten Content-Lifecycle-Frameworks unterteilen den Prozess in fünf bis sieben Phasen, von der Planung bis zur Archivierung.
Planung und Erstellung erhalten die meisten Tools und die größte Aufmerksamkeit. Fehlt ein klarer und verbindlicher Lifecycle-Prozess, improvisieren Teams häufig genau bei den Phasen, die darüber entscheiden, ob Content vertrauenswürdig bleibt: Organisation, Pflege und Archivierung.
Diese späteren Phasen verdienen ebenso viel Aufmerksamkeit wie die Erstellung. Denn eine fehlerhafte Seite, die online ist, richtet mehr Schaden an als ein Entwurf, der nie veröffentlicht wird. Zudem verbringt Content weit mehr Zeit in der Pflege als in der Erstellung.
Warum Content-Lifecycle-Management im Enterprise-Umfeld besonders wichtig ist
Content-Lifecycle-Management gewinnt an Bedeutung, sobald Content-Volumen, Anzahl der Kanäle und Anzahl der Märkte wachsen. Einige Hundert Seiten auf zehn lokalisierten Websites zu verwalten, jede mit eigenen Vorschriften und eigener Freigabe-Kette, und das allein aus dem Gedächtnis? Unmöglich.
Im Enterprise-Umfeld summieren sich die Folgekosten übersprungener Lifecycle-Phasen:
- Doppelter Content konkurriert mit sich selbst in der Suche. Finden Teams ein bestehendes Asset nicht, erstellen sie ein neues. Nahezu identische Seiten teilen sich dann die Rankings und verunsichern Käuferinnen und Käufer.
- Veraltete Seiten bergen rechtliche Risiken. Ein Preis, ein Disclaimer oder eine Aussage, die zum Launch korrekt war, bleibt online, obwohl sie längst nicht mehr zutrifft. In einem regulierten Markt wird das zum Compliance-Problem.
- Teams verlieren Stunden bei der Suche nach der aktuellen Version. Zeit, die in die Frage fließt, welche von fünf nahezu identischen Seiten tatsächlich korrekt ist, fehlt an anderer Stelle für die Optimierung.
- KI-Antworten greifen auf alles zurück, was online ist. Eine nie archivierte Seite kann von einem KI-Assistenten als aktuelle Antwort des Unternehmens zitiert werden. Eine übersprungene Phase wirkt sich damit direkt auf die Sichtbarkeit in der KI-Suche aus.
- Inkonsistente Informationen untergraben das Vertrauen von Kundinnen und Kunden. Weichen Preise, technische Daten oder Richtlinien zwischen den Kanälen voneinander ab, zweifeln Kundinnen und Kunden daran, welcher Version sie glauben können.
- Ohne Optimierung bleibt Conversion-Potenzial ungenutzt. Eine Seite, die zwar korrekt ist, aber nie anhand echter Performance-Daten überarbeitet wird, bleibt dauerhaft hinter ihren Möglichkeiten zurück.
Je größer der Content-Bestand, desto höher die Kosten jeder vernachlässigten Phase.
Wie die Archivierung alter Inhalte die Sichtbarkeit in der KI-Suche beeinflusst
Was heute archiviert wird, entscheidet darüber, ob KI-Tools eine Marke korrekt darstellen. Veraltete Seiten, die online bleiben, können von KI-Suchtools aufgegriffen und als aktuell zitiert werden. So wird eine vergessene Seite zur Quelle von Fehl-Informationen über die eigene Marke.
Noch problematischer wird es, wenn eine alte Seite einer neueren widerspricht. Stößt ein KI-System auf zwei unterschiedliche Antworten derselben Marke, kann es das Vertrauen in die Website als Quelle verlieren und stattdessen einen Wettbewerber nennen. Die Archivierung veralteter Versionen ist also keine reine Aufräum-Arbeit. Sie entscheidet mit darüber, welche Marke die KI zitiert.
Dieser Wandel ist messbar. Laut einer Analyse des Pew Research Center zu Browsing-Daten aus dem März 2025 führten 58 % der Nutzerinnen und Nutzer in den USA innerhalb eines Monats mindestens eine Suche durch, die eine KI-Zusammenfassung lieferte. Diese Zusammenfassungen stützten sich in der Regel auf drei oder mehr Quellen. KI-Tools stehen damit immer häufiger zwischen dem Content eines Unternehmens und seinen Kundinnen und Kunden. Ihre Antworten bauen sie aus den Seiten auf, die aktuell online sind.
Welche Quelle zitiert wird, lässt sich nicht beeinflussen. Sehr wohl steuern lässt sich jedoch, ob der eigene Content korrekt und aktuell ist. Genau deshalb wird das Archivieren und Aktualisieren alter Seiten zu einer Frage der Sichtbarkeit: Eine Seite, die nicht offline genommen wurde, kann als offizielle Antwort der Marke ausgespielt werden. Für Marken in regulierten Branchen ist das mehr als nur digitaler Ballast. Es ist ein Compliance- und Reputations-Risiko, das eine KI-Antwort noch verstärken kann.
Wo der Content-Lifecycle in internationalen Organisationen ins Stocken gerät
In Organisationen mit mehreren Märkten gerät der Lifecycle dort ins Stocken, wo verschiedene Teams und Märkte beteiligt sind. Eine Änderung an einer Master-Seite in einer Sprache erreicht nur selten automatisch alle lokalisierten Versionen. So kann dasselbe Produkt auf der deutschen Website korrekt und auf der spanischen fehlerhaft beschrieben sein.
Die Ursachen lassen sich meist auf folgende zentrale Herausforderungen zurückführen:
- Keine Single Source of Truth. Content ist über CMS, DAM, Präsentationen und lokale Laufwerke verteilt. Eine maßgebliche Version, die aktualisiert werden kann, gibt es nicht. Korrekturen erreichen daher nur einen Teil der Kopien.
- Keine klaren Verantwortlichkeiten. Niemand ist für die Version eines bestimmten Marktes zuständig. Steht eine Aktualisierung an, ist unklar, wer sich darum kümmern soll.
- Unpassende Berechtigungen. Wer feststellt, dass eine Seite aktualisiert werden muss, hat oft nicht die Rechte, sie zu ändern. Korrekturen bleiben liegen, bis die Person mit den nötigen Zugriffs-Rechten tätig wird.
- Kein Überblick über den vorhandenen Content. Ein vollständiges Inventar über alle Märkte hinweg fehlt. Doppelte und veraltete Seiten sammeln sich unbemerkt an. Content, von dessen Existenz niemand weiß, lässt sich weder prüfen noch aktualisieren oder archivieren.
- Kein fester Review-Rhythmus. Ohne festen Zeitplan für die Überprüfung fallen Seiten erst dann auf, wenn zufällig jemand ein Problem bemerkt.
- Kein Auslöser für die Synchronisierung über Sprachen und Kanäle hinweg. Ändert sich eine Quell-Seite, werden übersetzte Versionen oder andere Kanäle, die ebenfalls angepasst werden müssen, nicht automatisch markiert.
- Keine Kriterien für die Archivierung. Ohne Content-Audit, das zeigt, wann eine Seite ihren Zweck erfüllt hat, wird Content so gut wie nie gezielt offline genommen. Alte Seiten bleiben standardmäßig online und werden von KI-Systemen als aktuell ausgespielt.
- Kein verbindlicher Workflow mit Freigabe-Schritt im CMS. Content kann ohne Review online gehen oder offline genommen werden, ohne einer definierten Abfolge von Schritten zu folgen.
Diese Abläufe beruhen meist auf persönlichen Gewohnheiten statt auf festen Prozessen im CMS. Wechseln Mitarbeitende ihre Rolle, bricht der Prozess mit ihnen weg. Eine Bank, die Zins-Informationen in zwölf Ländern veröffentlicht, kann solche Fragen nicht der Gewohnheit überlassen. Sind Verantwortlichkeiten unklar, wirkt es am sichersten, alte Inhalte einfach online zu lassen. Tatsächlich ist genau das die riskanteste Option.
Warum Content-Pflege eine Abhängigkeits-Kette ist und keine Aufräum-Aufgabe
Content-Pflege im großen Maßstab ist eine Frage des Abhängigkeits-Managements und kein gelegentliches Aufräumen. Ändert sich ein Quell-Dokument, etwa ein Preis, ein Sicherheits-Hinweis oder ein rechtlicher Disclaimer, müssen auch alle damit verknüpften übersetzten und weiterverwendeten Versionen angepasst werden. Andernfalls laufen die Versionen auseinander.
Genau diesen Punkt übersehen die meisten Lifecycle-Leitfäden. Übersetzungen sind keine eigenständigen Kopien. Sie bleiben mit einer Quelle verknüpft. Hinzu kommt, dass die Gültigkeit je nach Markt variieren kann: Eine Aussage, die in einem Land zulässig ist, kann in einem anderen eingeschränkt sein. Wird jede lokalisierte Seite als eigenständiges Asset behandelt, erreicht eine korrigierte mehrsprachige Aussage am Ende nur einen Teil der Märkte.
Nicht jede Änderung muss sich auf alle Versionen auswirken. Bestimmte Änderungen müssen jedoch jede Version erreichen, die von der Quelle abhängt.
Genau das automatisiert ein Master-to-Derived-Publishing-Workflow: Eine Änderung an der Quelle markiert und aktualisiert die abhängigen Versionen. Eine Tabelle mit Änderungen, die per E-Mail an jeden Markt verschickt und dort manuell umgesetzt wird, ist damit überflüssig.
Warum modularer, strukturierter Content die Pflege erleichtert
Modularer, strukturierter Content sorgt dafür, dass die späteren Phasen auch im großen Maßstab funktionieren. Wird Content als typisierte, miteinander verknüpfte Objekte statt als statische Seiten gespeichert, wirkt sich eine einzige Aktualisierung auf jede Stelle aus, an der das Objekt verwendet wird. Zugleich können Maschinen den Content lesen, verifizieren und zitieren.
Eine Produkt-Information, die einmal modelliert und auf einer Landing-Page, einer Kategorie-Seite und in einer E-Mail referenziert wird, ändert sich überall in dem Moment, in dem das Objekt aktualisiert wird. Genau das unterscheidet eine skalierbare Pflege von einer, die davon abhängt, dass sich jemand an jede Seite erinnert, auf der diese Information auftaucht.
Dieselbe Struktur macht Content auch für KI-Systeme verständlich. Explizit modellierte Beziehungen zeigen etwa, welche Produkte zusammengehören und welche Aussage in welchem Markt gilt. Damit erhält eine KI eine Grundlage, die sie verifizieren kann, statt Zusammenhänge ableiten zu müssen. Genau das ist entscheidend, um bei spezifischen Suchanfragen mit hoher Kauf-Absicht zu punkten. Ausführlicher behandeln wir das Thema im Leitfaden zum strukturierten Content-Modell sowie im Beitrag darüber, wie ein KI-gestütztes CMS dabei unterstützt. Für den Content-Lifecycle gilt: Erst die Struktur ermöglicht es, Pflege, Archivierung und KI-Readiness gemeinsam zu skalieren.
Wer für den Content-Lifecycle verantwortlich ist: Governance und menschliche Kontrolle
Ohne klare Verantwortung für jede Phase des Lifecycles werden einzelne Phasen leicht übersprungen. Governance ist die Ebene, die diese Verantwortlichkeiten festlegt: wer Content erstellt, wer ihn freigibt, wer ihn veröffentlicht und wer über die Archivierung entscheidet.
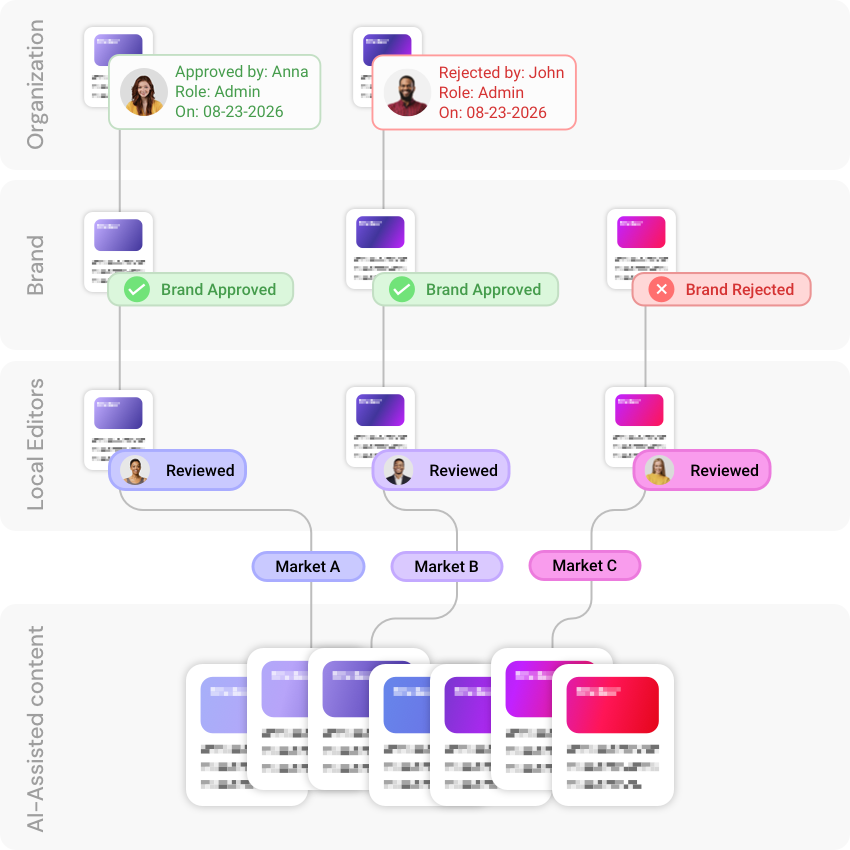
Im Enterprise-Umfeld sind diese Berechtigungen meist hierarchisch aufgebaut, von der Organisation über die Marke bis hin zum einzelnen Markt. So können lokale Redakteurinnen und Redakteure ihre Website selbst aktualisieren, während globale Managerinnen und Manager den Überblick behalten.
Dasselbe Prinzip gilt für KI-gestützten Content: Der Mensch sollte die Führung behalten und die finale Entscheidung über die Veröffentlichung treffen (Human in the Lead), statt nur gelegentlich zu prüfen (Human in the Loop). KI kann einen größeren Teil des Volumens übernehmen, Marken-Richtlinien und Freigaben bleiben jedoch in menschlicher Hand. Lifecycle-Management und Content-Governance sind zwei Seiten desselben Systems: Das eine beschreibt die Phasen, das andere legt fest, wer sie steuert.
Wie CoreMedia den Content-Lifecycle im Enterprise-Umfeld unterstützt
Die CoreMedia Digital Experience Platform bildet Content als miteinander verknüpfte, strukturierte Objekte statt als eigenständige Seiten ab. Damit erhalten Teams den nötigen Rahmen, um auch die späteren Phasen wie Pflege, Lokalisierung und Archivierung im Enterprise-Umfeld beherrschbar zu halten.
So sieht das in den einzelnen Phasen aus:
- Zeit-Steuerung für jedes Content-Element: Content verfügt standardmäßig über Gültigkeits-Daten für Beginn und Ende. Veröffentlichung und Archivierung lassen sich so auf Ebene des einzelnen Elements festlegen.
- Strukturiertes Content-Modell: Typisierte, wiederverwendbare Objekte sorgen dafür, dass eine einzige Änderung auf jede Seite und jeden Kanal übertragen wird, der darauf verweist.
- Lokalisierungs-Workflows: Content wird auf einer Master-Site veröffentlicht, zur Übersetzung weitergeleitet und nach der Freigabe mit den abgeleiteten Sites synchronisiert. So bleiben die Märkte auch bei Aktualisierungen der Quelle auf dem gleichen Stand.
- Omnichannel-Vorschau: Vor der Veröffentlichung ist sichtbar, wie Content auf Website, App, Tablet und als JSON dargestellt wird. Fehler werden so bereits beim Publizieren erkannt und nicht erst danach.
- Governance und Rollen: Hierarchische Berechtigungen und Freigabe-Workflows bilden Verantwortlichkeiten von global bis lokal ab, ganz ohne individuelle Entwicklung.
- KI mit menschlicher Kontrolle: CoreMedia KIO unterstützt bei der Erstellung, bei Metadaten und bei der Optimierung. Jeder Vorschlag erfordert die Freigabe durch Redakteurinnen und Redakteure, der Mensch behält also die Führung.
- Composable Architektur: Bevorzugte Übersetzungs-Tools, Customer-Data-Plattformen oder Commerce-Systeme lassen sich ohne kompletten Austausch der Infrastruktur integrieren. Einzelne Bestandteile des Tech-Stacks können so ersetzt oder abgelöst werden, ohne den darauf basierenden Content zu beeinträchtigen.
Entscheidend ist nicht die Liste der Funktionen. Entscheidend ist, dass Pflege und Archivierung, also genau die Phasen, die im großen Maßstab ins Stocken geraten, zur Routine werden, wenn eine Plattform Content von Anfang an als strukturiert und verknüpft behandelt.
Der wahre Prüfstein für Content-Lifecycle-Management ist nicht die Planung oder Veröffentlichung, sondern das, was mit Content nach dem Go-live geschieht. Bei Pflege, Lokalisierung und Archivierung entscheidet sich, ob Korrektheit, Compliance und Sichtbarkeit in der KI-Suche gewährleistet sind. Gerade diese Phasen behandeln allgemeine Frameworks jedoch nur oberflächlich. Wer den eigenen Content-Lifecycle abbilden möchte, sollte zunächst für jede Phase nach der Veröffentlichung eine verantwortliche Person und einen Review-Auslöser festlegen. Welche Rollen und Workflows das Ganze zusammenhalten, zeigt unser Leitfaden zur Content-Governance.
Häufig gestellte Fragen (FAQs)
Welche Phasen umfasst Content-Lifecycle-Management?
Die Phasen des Content-Lifecycle-Managements sind in der Regel Planung, Erstellung, Organisation, Veröffentlichung, Optimierung, Pflege und Archivierung. Manche Frameworks fassen sie zu fünf Phasen zusammen, andere erweitern sie auf sieben. Die Abfolge bleibt jedoch gleich: Content wird geplant, produziert, gespeichert, veröffentlicht, verbessert, aktuell gehalten und schließlich archiviert oder entfernt. Die späteren Phasen sind dabei ebenso wichtig wie die ersten.
Worin unterscheiden sich Content-Lifecycle-Management und Content-Governance?
Content-Lifecycle-Management beschreibt die Abfolge der Phasen, die ein Content-Element durchläuft. Content-Governance ist dagegen das System aus Rollen, Standards und Freigaben, das steuert, wie dieser Ablauf erfolgt. Lifecycle-Management beschreibt also, was mit dem Content geschieht. Governance legt fest, wer welche Änderung nach welchen Regeln vornehmen darf. Unternehmen brauchen beides, denn Phasen ohne klare Verantwortung werden nicht umgesetzt.
Warum ist Content-Lifecycle-Management für SEO und KI-Suche wichtig?
Content-Lifecycle-Management ist für SEO und KI-Suche wichtig, weil Sichtbarkeit davon abhängt, dass Content korrekt und aktuell bleibt. Genau das sichern die Phasen Pflege und Archivierung. Veraltete oder doppelte Seiten können Rankings schaden und von KI-Tools so zitiert werden, als wären sie noch gültig. Erst strukturierter und aktueller Content ist für Suchmaschinen und KI-Systeme zuverlässig auffindbar.
Wie lässt sich der Content-Lifecycle über mehrere Sprachen oder Märkte hinweg steuern?
Den Content-Lifecycle über mehrere Märkte hinweg zu steuern bedeutet, übersetzte Seiten als Versionen zu behandeln, die mit einer Quelle verknüpft sind, und nicht als eigenständige Kopien. Ändert sich die Quelle, muss jede verknüpfte Version geprüft werden. Lokale Reviews sind dabei wichtig, da manche Aussagen in einem Markt zulässig, in einem anderen jedoch eingeschränkt sein können. Ein Lokalisierungs-Workflow, der eine Master-Site mit ihren abgeleiteten Sites verbindet, hält die Märkte auch bei Änderungen auf dem gleichen Stand.
Erfordert Content-Lifecycle-Management ein bestimmtes CMS?
Content-Lifecycle-Management setzt kein bestimmtes CMS voraus. Mit einem Enterprise-CMS wie CoreMedia, das Content als strukturierte Objekte abbildet und Zeit-Steuerung, Workflows und Lokalisierung integriert, gelingt es jedoch deutlich leichter. Systeme, die Content als statische Seiten speichern, zwingen Teams dazu, jede Version manuell zu pflegen. Mit wachsendem Content-Volumen und steigender Zahl an Märkten stößt dieser Ansatz schnell an seine Grenzen. Eine strukturierte, composable Plattform sorgt dafür, dass eine einzige Änderung an jede Stelle übertragen wird, an der der Content erscheint.
Wie unterstützt CoreMedia bei der Optimierung des Content-Lifecycle-Managements?
CoreMedia verwaltet Content als strukturierte, miteinander verknüpfte Objekte. So bleiben auch die späteren Phasen im großen Maßstab beherrschbar. Eine Änderung an der Quelle aktualisiert jede Seite und jede Übersetzung, die darauf verweist. Gültigkeits-Daten für Beginn und Ende steuern Veröffentlichung und Archivierung auf Ebene des einzelnen Elements, und Lokalisierungs-Workflows halten die Märkte bei Änderungen an der Quelle auf dem gleichen Stand. Governance-Rollen und Freigaben legen fest, wer welche Phase steuert. CoreMedia KIO unterstützt bei der Erstellung und bei Metadaten, während die finale Entscheidung über die Veröffentlichung beim Menschen bleibt.